로컬 AI와 분산 컴퓨팅: 대규모 문서 처리의 새로운 가능성
한 대로 감당하기 어려운 문서 작업을, 각자의 컴퓨터에 설치한 로컬 AI가 나눠 처리했습니다. 넥서스가 보여 준 것은 연산의 분산과 실행의 문턱이 낮아지는 변화입니다. 파일을 보관하던 DX에서, 기록에 질문하고 행동하는 AX로 넘어가는 이야기입니다.
하드디스크에 문서는 많았습니다. 막상 AI에게 읽혀 보니, 그중 상당수는 다시 손봐야 했습니다.
화면에서는 멀쩡한 PDF인데 글자를 복사하면 순서가 뒤섞였습니다. 문단이 깨지고, 검색해도 나와야 할 문장이 나오지 않았습니다. 오래 모아 둔 자료가 있다는 사실과 그 자료를 실제로 쓸 수 있다는 사실 사이에는 생각보다 큰 간격이 있었습니다.
처음 바란 것은 단순했습니다. 이 문서들을 제대로 읽을 수 있게 만들고 싶었습니다.
그런데 양이 수만 권이 되자 작은 바람이 인프라 문제가 됐습니다. 제 컴퓨터 한 대로는 시간이 너무 오래 걸렸습니다. 외부 AI에 페이지마다 처리를 맡기는 방식은 전체 분량을 계산하는 순간 부담이 커졌습니다. 더 좋은 GPU, 클라우드 서버, 더 큰 예산이 필요하다는 결론으로 자꾸 돌아갔습니다.
그러다 질문을 바꿨습니다.
“이 일을 꼭 한 대가 전부 해야 할까?”
Project Nexus는 그 질문을 실제로 돌아가는 시스템으로 옮긴 기록입니다. 이 과정을 지나며 개인이 AI 시대에 어디까지 일을 밀어붙일 수 있는지도 다시 보게 됐습니다.
불가능하다는 판단 안에 숨어 있던 전제
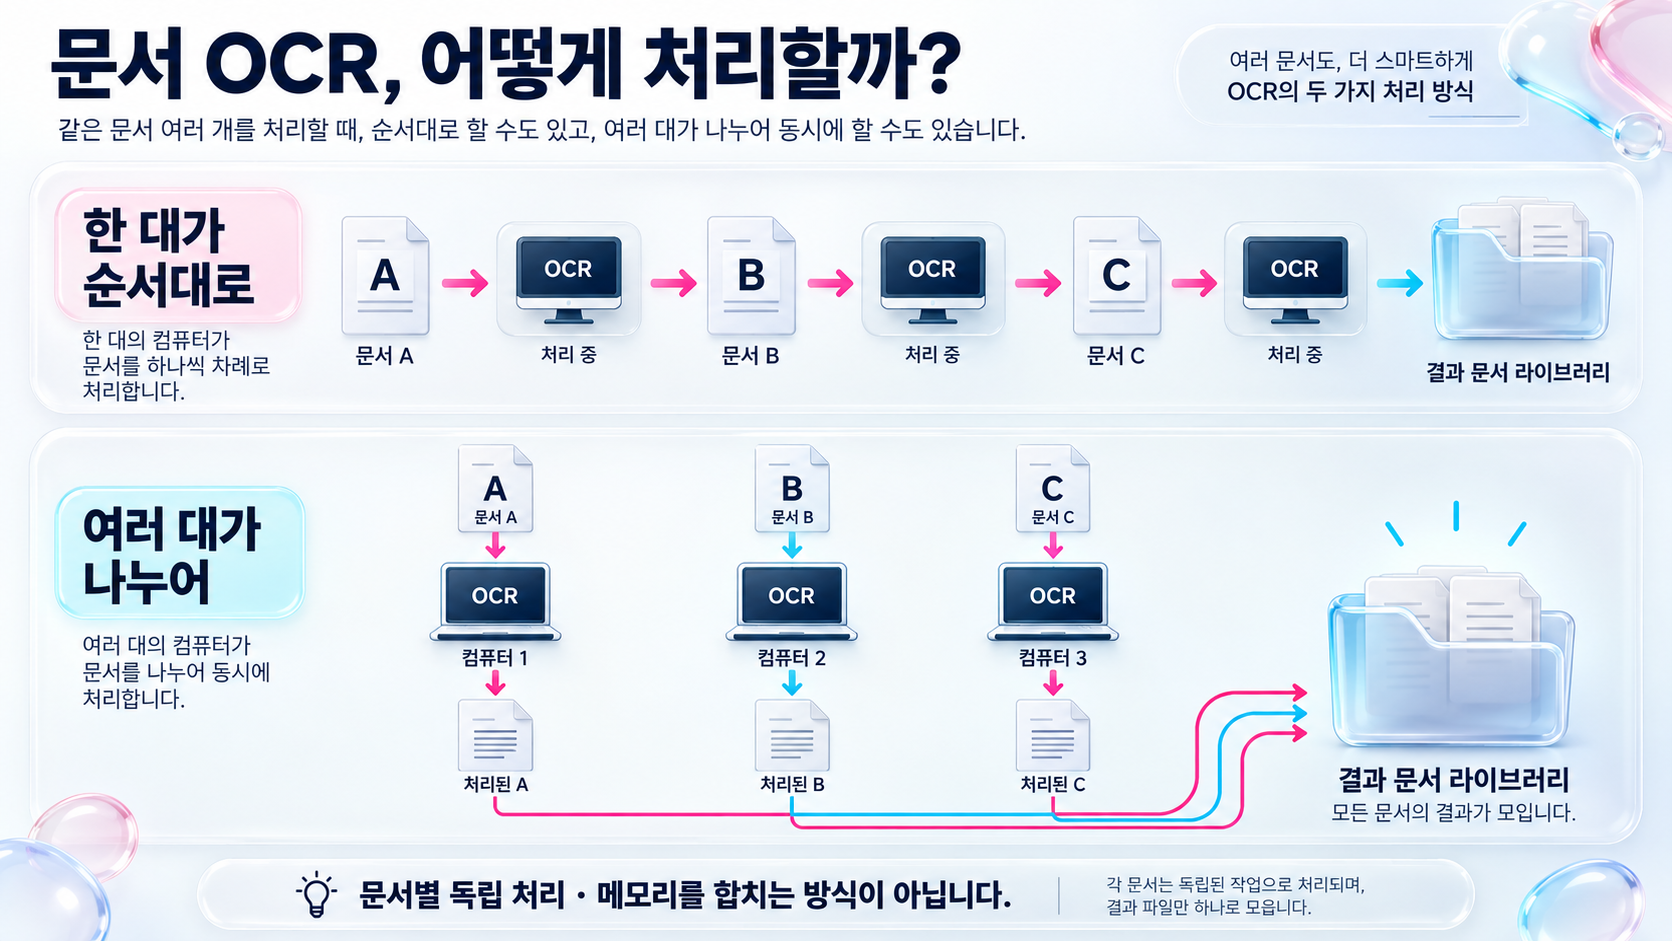
컴퓨터 한 대가 문서 하나를 읽는 속도에는 한계가 있습니다. 모델을 줄이거나 GPU를 바꾸면 빨라질 수 있지만, 처리해야 할 양이 훨씬 크면 여전히 오래 걸립니다.
이 작업에는 분산에 맞는 성질이 있었습니다. A 문서의 OCR이 끝나야 B 문서를 시작할 필요가 없었습니다. 각 문서를 따로 읽고 결과만 모으면 됐습니다.
그렇다면 컴퓨터 A는 첫 번째 문서, B는 두 번째 문서, C는 세 번째 문서를 맡으면 됩니다. 한 대의 처리 능력을 높이는 방법에, 여러 대의 처리 시간을 겹치는 방법이 더해집니다.
여러 컴퓨터의 메모리를 합쳐 거대한 AI 모델 하나를 실행하는 방식은 아닙니다. 각 컴퓨터가 자기 메모리 안에 들어가는 모델로 별개의 문서를 처리합니다. 그래서 장비 사양이 모두 같을 필요는 없습니다. 다만 모델을 실행할 최소 메모리와 참여할 만한 처리 속도는 있어야 합니다.
이 독립성이 프로젝트를 가능하게 만든 첫 번째 조건이었습니다. 분산은 모든 일을 똑같이 빠르게 만들지 않습니다. 작업을 나눌 수 있는 지점을 찾았을 때 효과가 납니다.
각자의 책상 위에 있던 연산 능력
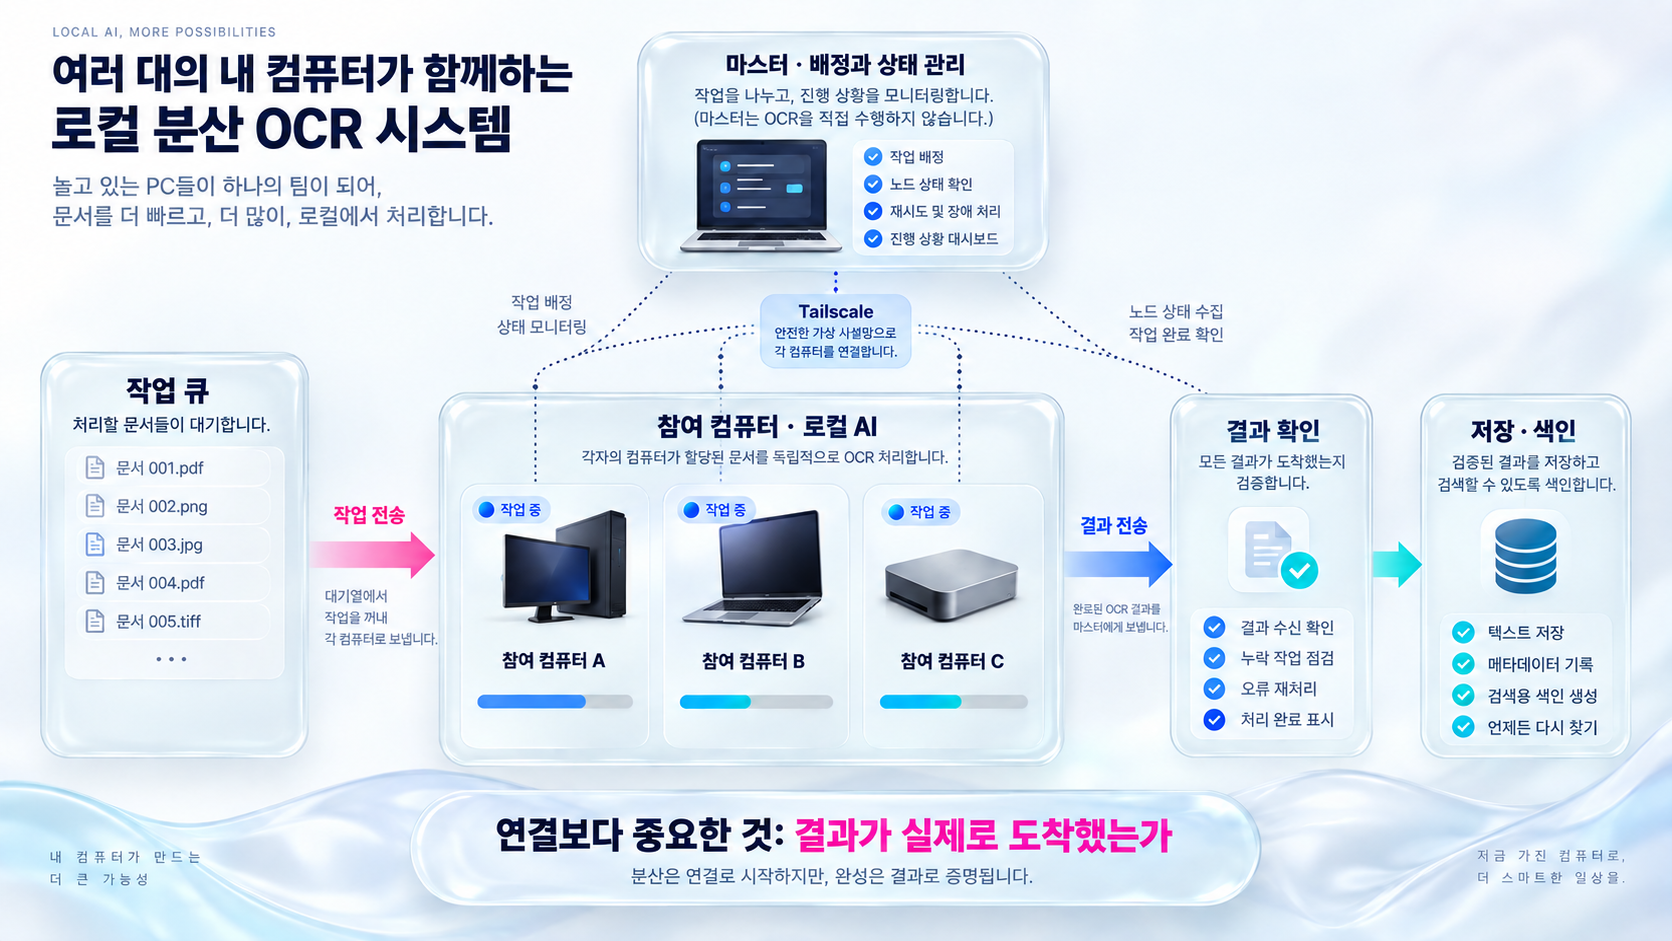
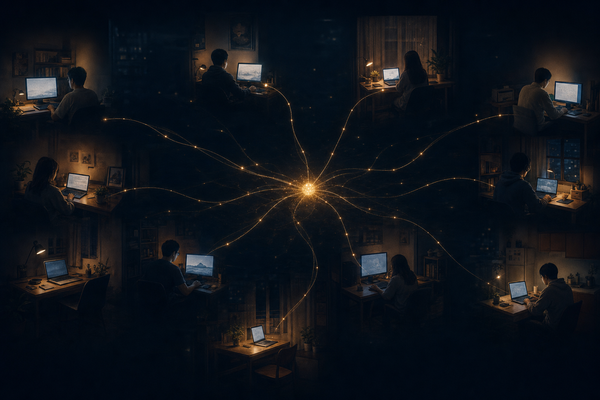
참여자의 맥과 윈도우 PC에 로컬 AI·OCR 환경을 설치했습니다. 서로 다른 장소의 컴퓨터는 Tailscale로 연결했고, 마스터가 문서 작업을 배정하도록 했습니다. 참여 컴퓨터는 작업을 받아 처리하고, 결과를 반환한 뒤 다음 작업을 받았습니다.
작업 큐 → 참여 컴퓨터 → 로컬 OCR·문서 변환 → 결과 수신·확인 → 저장·색인
이 구조에서 마스터는 모든 페이지를 직접 읽는 기계가 아닙니다. 누가 무엇을 맡았는지, 어떤 작업이 끝났는지, 결과가 제대로 도착했는지를 관리합니다. 무거운 문서 처리는 각자의 컴퓨터로 분산됩니다.
빠른 장비는 먼저 끝내고 다음 문서를 받습니다. 느린 장비도 자기 속도로 일합니다. 네트워크와 저장소가 받쳐 주면 서로 다른 컴퓨터가 같은 프로젝트에 기여할 수 있습니다.
다만 대수가 늘어날수록 다운로드와 업로드가 몰리고 중앙 저장소가 바빠집니다. 100대를 연결했다고 정확히 100배 빨라지는 것은 아닙니다. 어느 순간부터는 모델의 속도만큼 결과를 받아 주는 구조가 중요해집니다.
이전 넥서스 글에는 그 과정의 장애를 기록했습니다. 저장소 연결이 끊겼는데 같은 이름의 로컬 폴더에 파일이 들어간 일, 오래 걸리는 데이터베이스 조회 때문에 대시보드가 멈춘 일, 서버가 바빠 일하는 컴퓨터를 오프라인으로 오해한 일이 있었습니다.
아이디어가 작동하려면 이 사소해 보이는 실패도 처리해야 했습니다. 결과를 받았다는 응답과 실제 파일의 존재를 맞추고, 진행 중이라는 표시와 실제 페이지의 증가를 대조했습니다. 연결된 컴퓨터들이 끝까지 일할 수 있도록 만드는 일이 곧 프로젝트의 기술이었습니다.
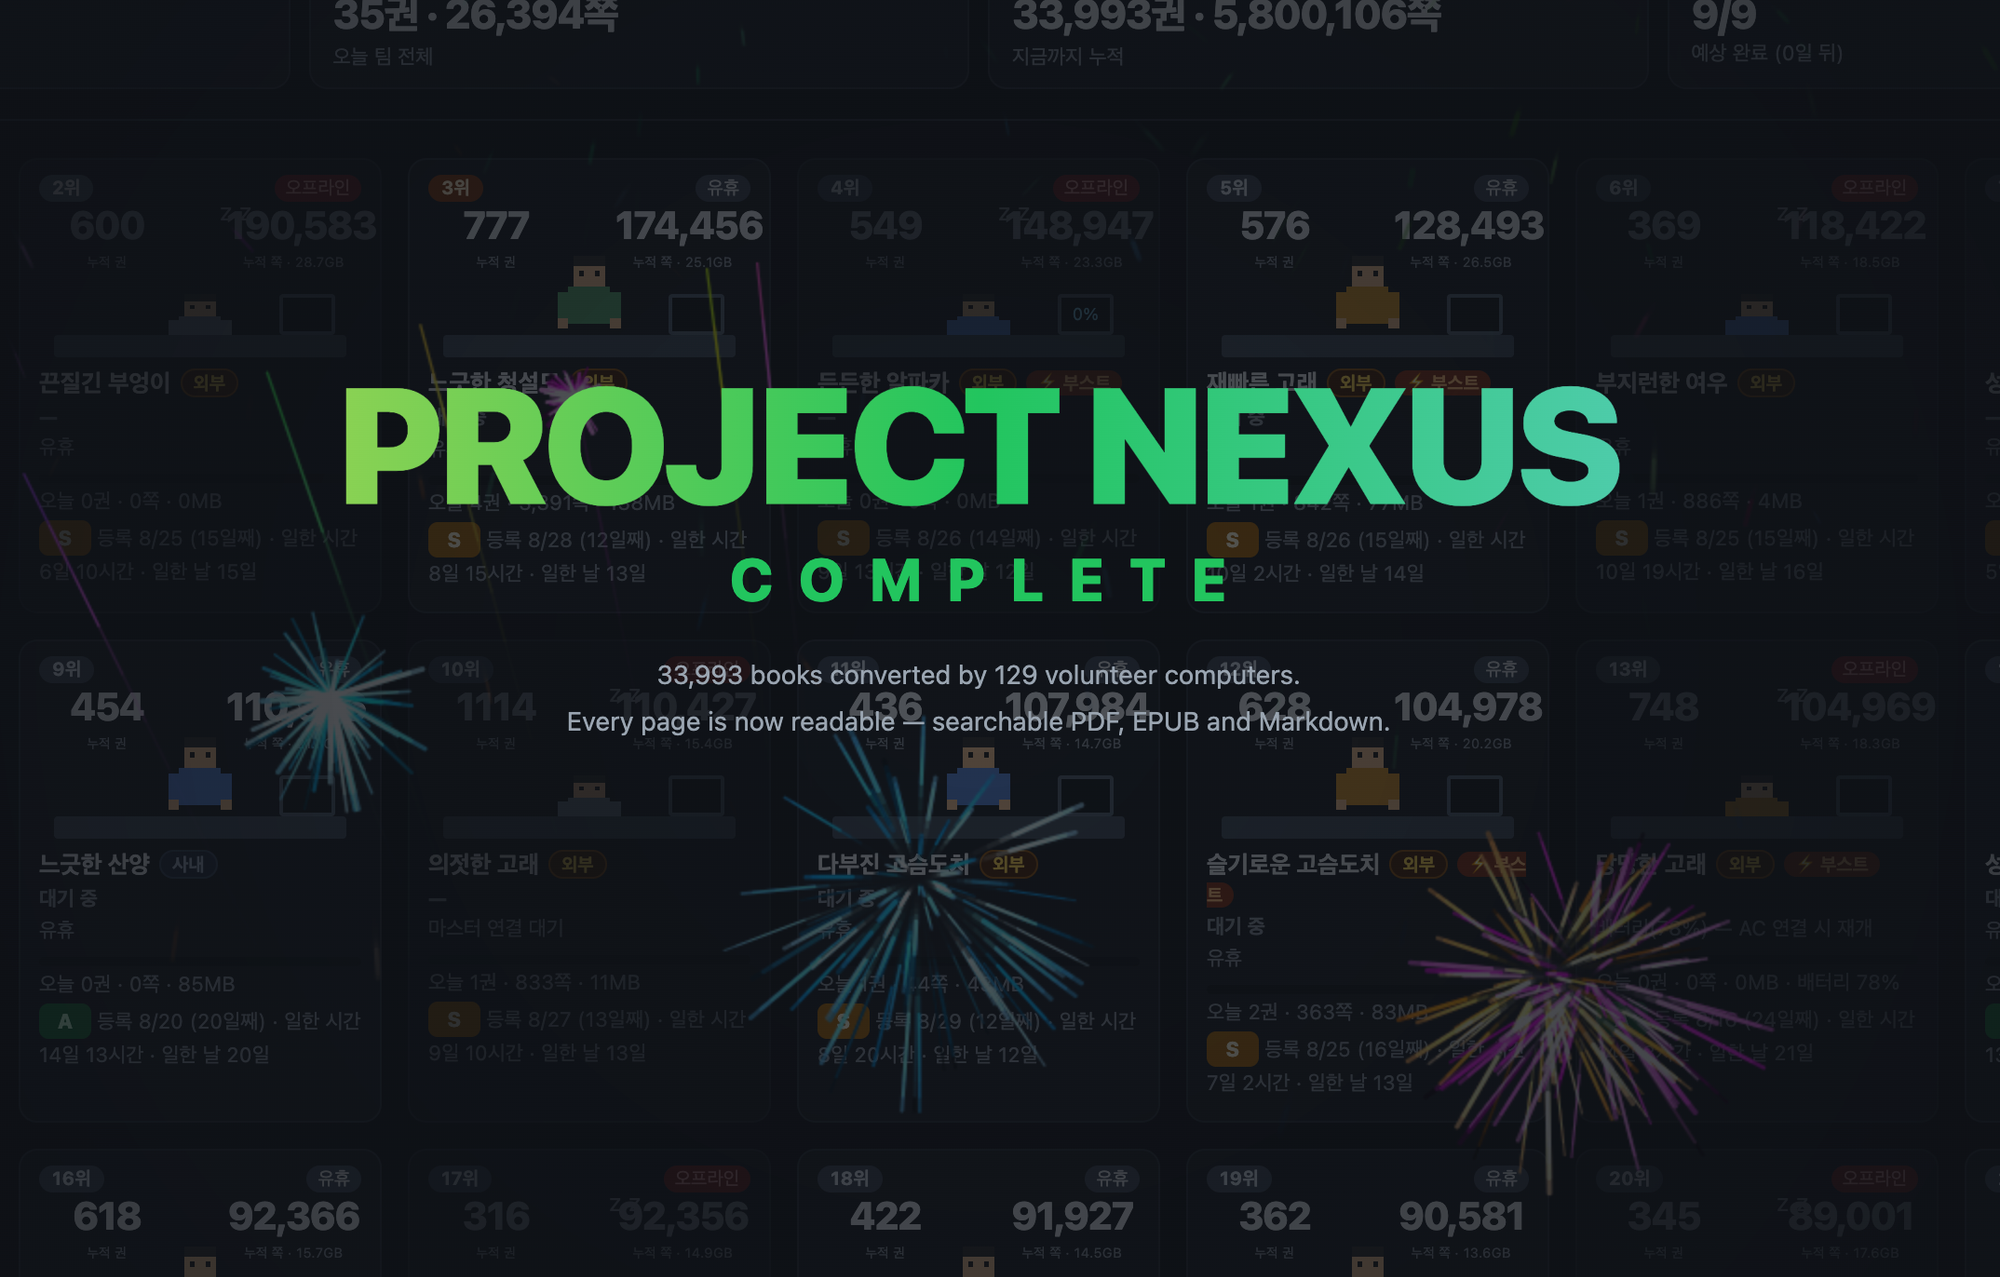
580만 페이지, 그리고 서로 다른 완료 숫자
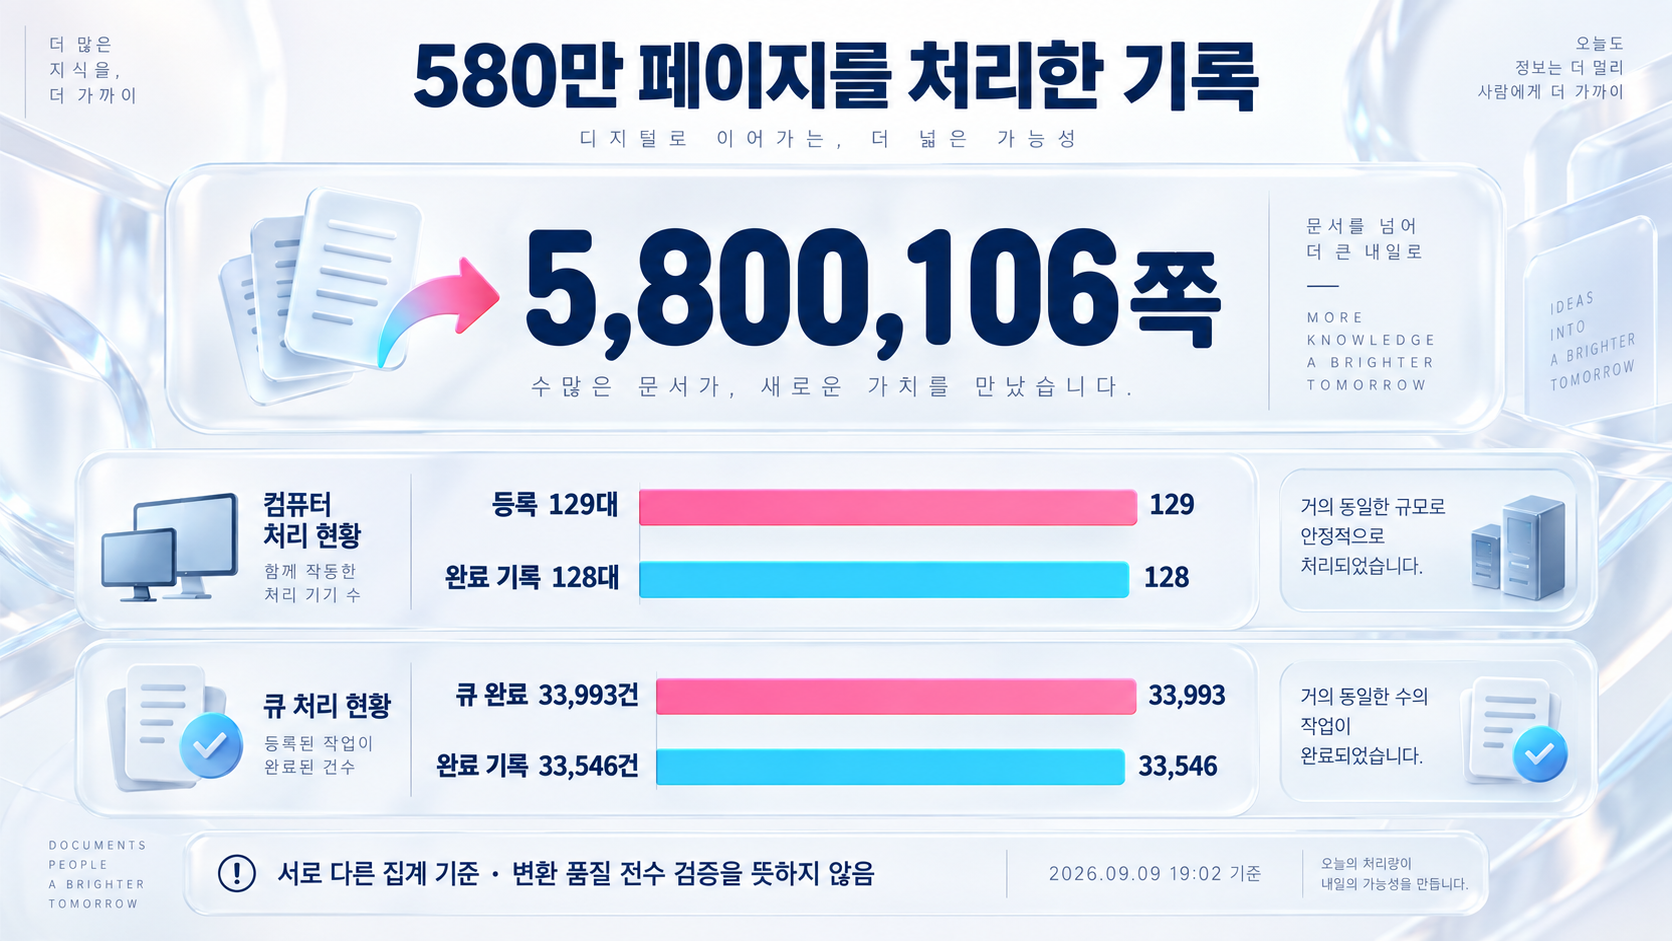
2026년 9월 9일 19시 2분 기준, 넥서스 보고서 API에서 확인한 기록입니다.
| 항목 | 보고서 값 |
|---|---|
| 등록 컴퓨터 | 129대 |
| 완료 기록이 있는 컴퓨터 | 128대 |
| 전체 작업 큐 / 완료 상태 | 33,993건 / 33,993건 |
| 완료 기록 집계 | 33,546건 |
| 누적 페이지 집계 | 5,800,106쪽 |
여기서 큐의 완료 상태와 완료 기록 집계는 서로 다른 지표입니다. 큐가 모두 닫혔다고 해서 33,993권 각각의 변환 품질까지 전수 검증됐다는 뜻은 아닙니다. 두 집계의 차이는 추가 대조가 필요하며, 이 글에서는 보고서 값을 구분해 적었습니다.
숫자가 보여 주는 확실한 변화는 있습니다. 한 사람이 자기 컴퓨터 앞에서 감당하기 어려워했던 규모의 작업이, 여러 사람의 장비와 시간을 연결하자 실제 처리 기록으로 남았습니다.
약 8,805만원과 약 24만원을 어떻게 읽어야 할까
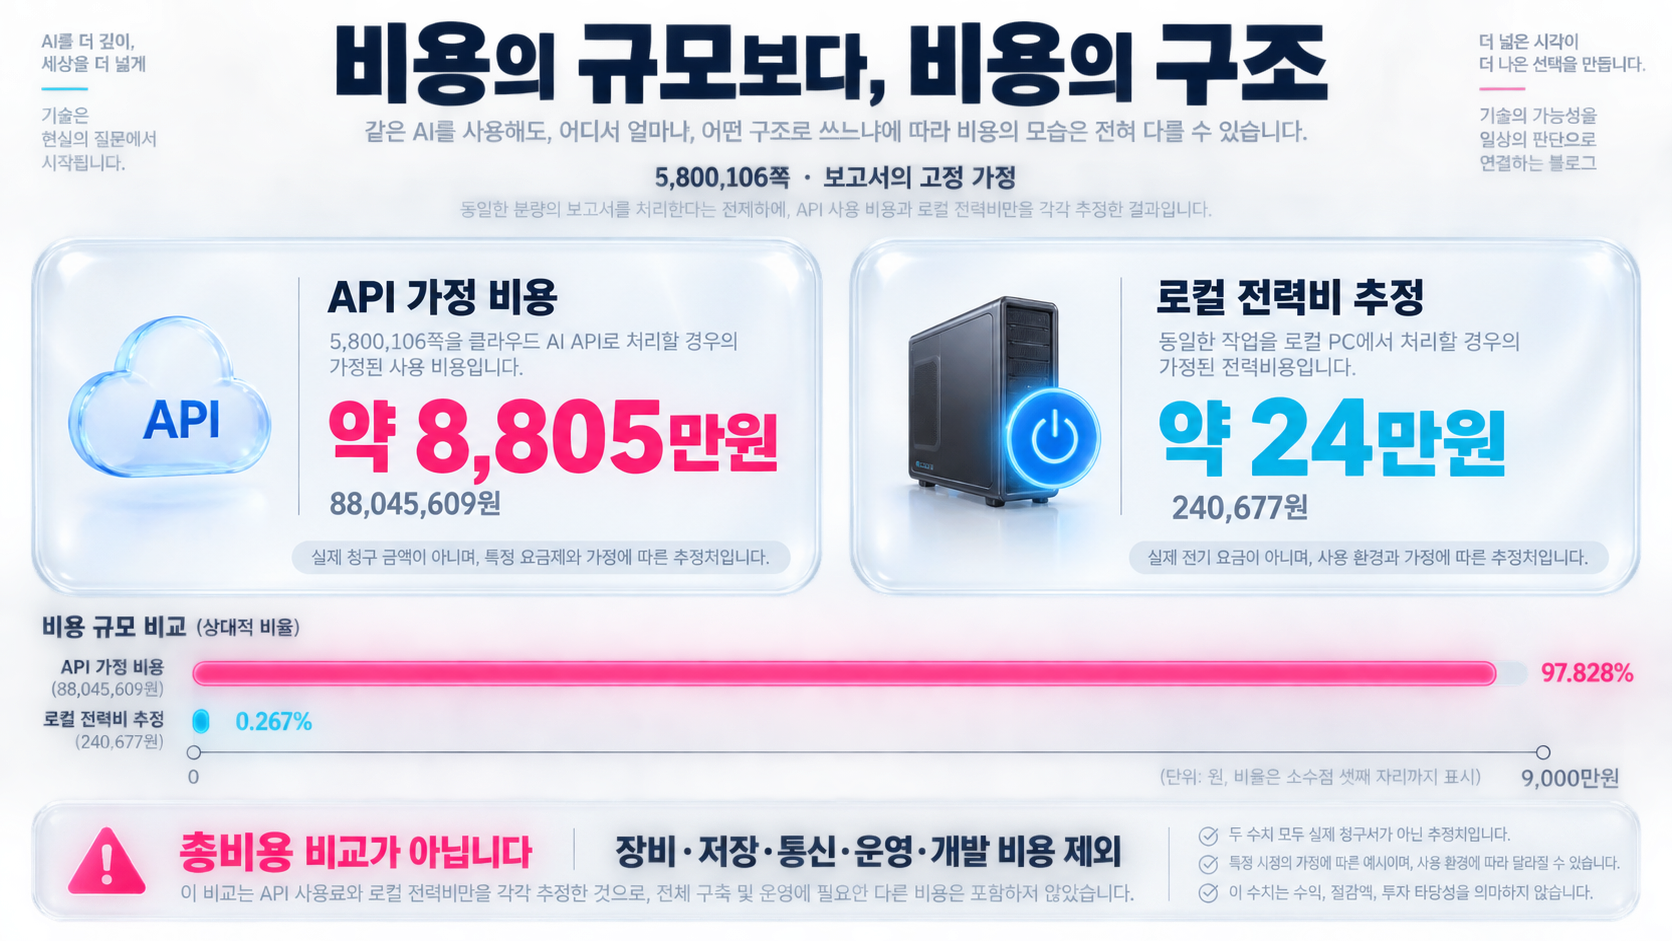
보고서에는 눈길을 끄는 비용 비교가 있습니다. 같은 페이지 수를 정해진 API 조건으로 처리한다고 가정한 금액은 약 8,805만원, 장비별 소비전력과 작업 시간으로 계산한 전력비는 약 24만원입니다.
두 숫자를 곧바로 ‘실제 견적’과 ‘실제 청구서’로 읽으면 안 됩니다. 모두 보고서의 계산값입니다.
API 쪽은 페이지당 입력 1,200토큰과 출력 800토큰, 100만 토큰당 입력 2.5달러·출력 10달러, 달러당 1,380원을 적용했습니다. 한 페이지에 약 15.18원, 5,800,106쪽에 약 88,045,609원이 나오는 계산입니다. 보고서가 GPT-4o 비교 시나리오에 사용한 고정 단가이며, 현재 서비스 견적이나 최저가 처리 방식이라는 의미는 아닙니다.
전력 쪽은 장비마다 전력계로 측정하지 않았습니다. 기종별 추정 소비전력에 작업 시간을 적용한 약 1,504.2kWh와 kWh당 160원을 사용했습니다. 보고서의 전력비 추정은 240,677원입니다. 장비별 가정의 정확도에 따라 달라질 수 있습니다.
하드웨어의 감가상각, 저장장치, 통신, 운영 노동, 개발에 사용한 AI 서비스 비용은 이 전력비에 들어 있지 않습니다. 로컬 OCR과 범용 비전 모델의 결과 품질이 동일하다는 비교 실험도 아닙니다. 따라서 두 값의 차이인 약 8,780만원을 검증된 순절감액으로 부르지는 않겠습니다.
그래도 비용 구조의 차이는 분명합니다. 페이지마다 외부 모델을 호출하는 지출을 줄이고, 이미 가진 장비의 연산 시간으로 대량 처리를 했습니다. 한 사람에게 몰리던 현금 지출을 낮출 방법이 생긴 셈입니다.
대규모 문서 처리에 데이터센터나 클라우드가 언제나 필수인 것은 아닙니다. 작은 작업이나 사용 빈도가 낮은 작업에는 API가 더 경제적일 수 있습니다. 넥서스처럼 독립적인 작업이 아주 많고, 활용 가능한 장비와 참여자가 있는 경우에는 로컬 분산이라는 선택지가 힘을 갖습니다.
AI는 문서를 읽었고, 저는 AI와 함께 시스템을 만들었습니다
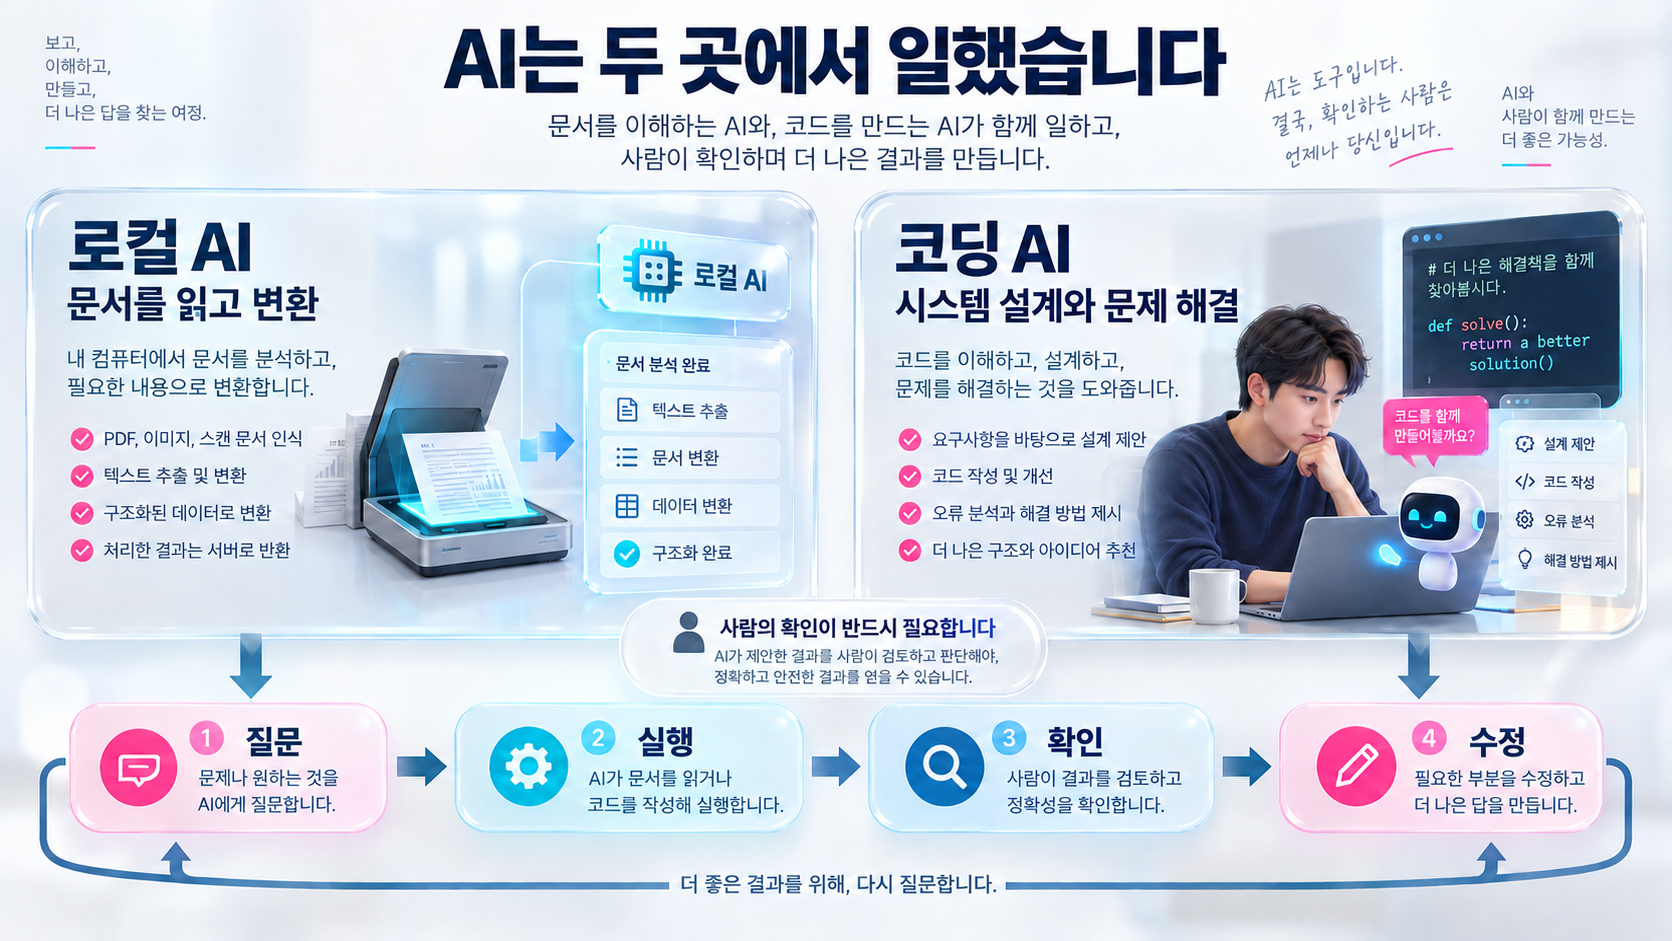
이 프로젝트에는 AI가 두 번 등장합니다.
첫 번째는 참여 컴퓨터에서 문서를 읽는 로컬 AI입니다. 두 번째는 그 컴퓨터들을 연결하고 운영하는 소프트웨어를 함께 만드는 코딩 AI입니다.
저는 개발자가 아닙니다. 연결 실패와 업로드 오류를 발견할 수는 있어도, 원인을 혼자 코드로 추적하기는 어려웠습니다. Claude Code와 함께 로그를 확인하고, 원인을 좁히고, 수정안을 시험하면서 그 간격을 건넜습니다.
‘업로드가 안 되는 것 같다’는 관찰은 저장 경로를 확인하는 작업이 됐습니다. ‘왜 여러 대가 동시에 멈추지?’라는 질문은 공통 서버의 병목을 찾는 조사로 이어졌습니다. 질문에 확인할 대상이 붙고, 그 확인에 코드와 실행 결과가 붙었습니다.
Anthropic은 에이전트 설계 지침에서 다음 원칙을 제시합니다.
“Maintain simplicity in your agent’s design.”
“에이전트의 설계를 단순하게 유지하라.” — Anthropic, 「Building effective agents」, 필자 번역
이 지침은 환경에서 얻은 실행 결과로 진행 상황을 판단하는 중요성도 설명합니다. 넥서스의 문서 배정은 정해진 프로그램이 수행하지만, 운영 문제를 AI와 함께 풀 때는 이 피드백 원리가 유용했습니다. 증상을 주고, 실행하고, 결과를 확인하고, 다시 고치는 순환입니다.
개인의 아이디어가 가치로 바뀌는 과정도 이와 닮았습니다. 질문이 설계로, 설계가 작은 실험으로, 실험이 검증된 작업 흐름으로 이어집니다. 만들어진 흐름은 다음 문서에서도 반복됩니다. 한 번 답을 듣는 데서 얻는 편익에, 계속 사용할 수 있는 시스템의 가치가 더해집니다.
DX로 보관한 문서에, AX로 질문한다
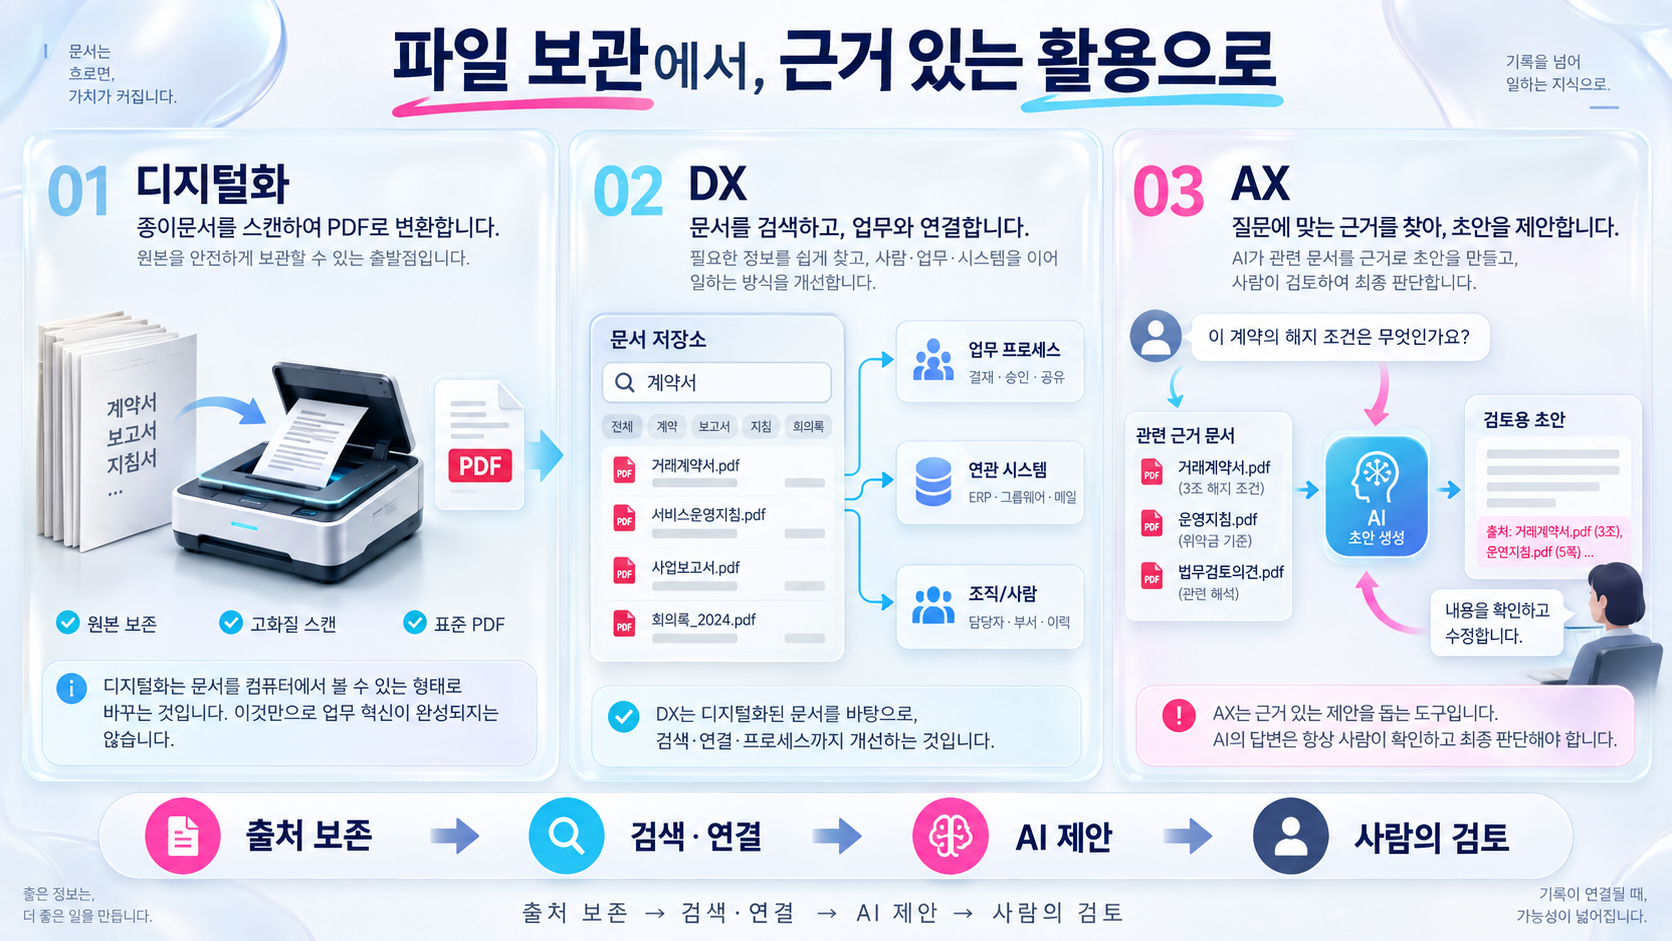
종이를 스캔해 PDF로 만드는 일은 엄밀히 말하면 디지털화입니다. DX, 곧 디지털 전환은 이를 넘어 업무 방식과 서비스의 변화까지 포함합니다. 다만 개인의 문서 생활에서는 ‘파일로 옮겨 두었다’는 지점에 변화가 머무는 경우가 많습니다.
이미 디지털인 문서도 마찬가지입니다. PDF가 있다는 사실만으로 내용이 구조화되거나 서로 연결되지는 않습니다. 스캔본의 이미지, 표의 읽기 순서, 출처와 작성 시점이 제대로 남아야 이후 활용이 쉬워집니다.
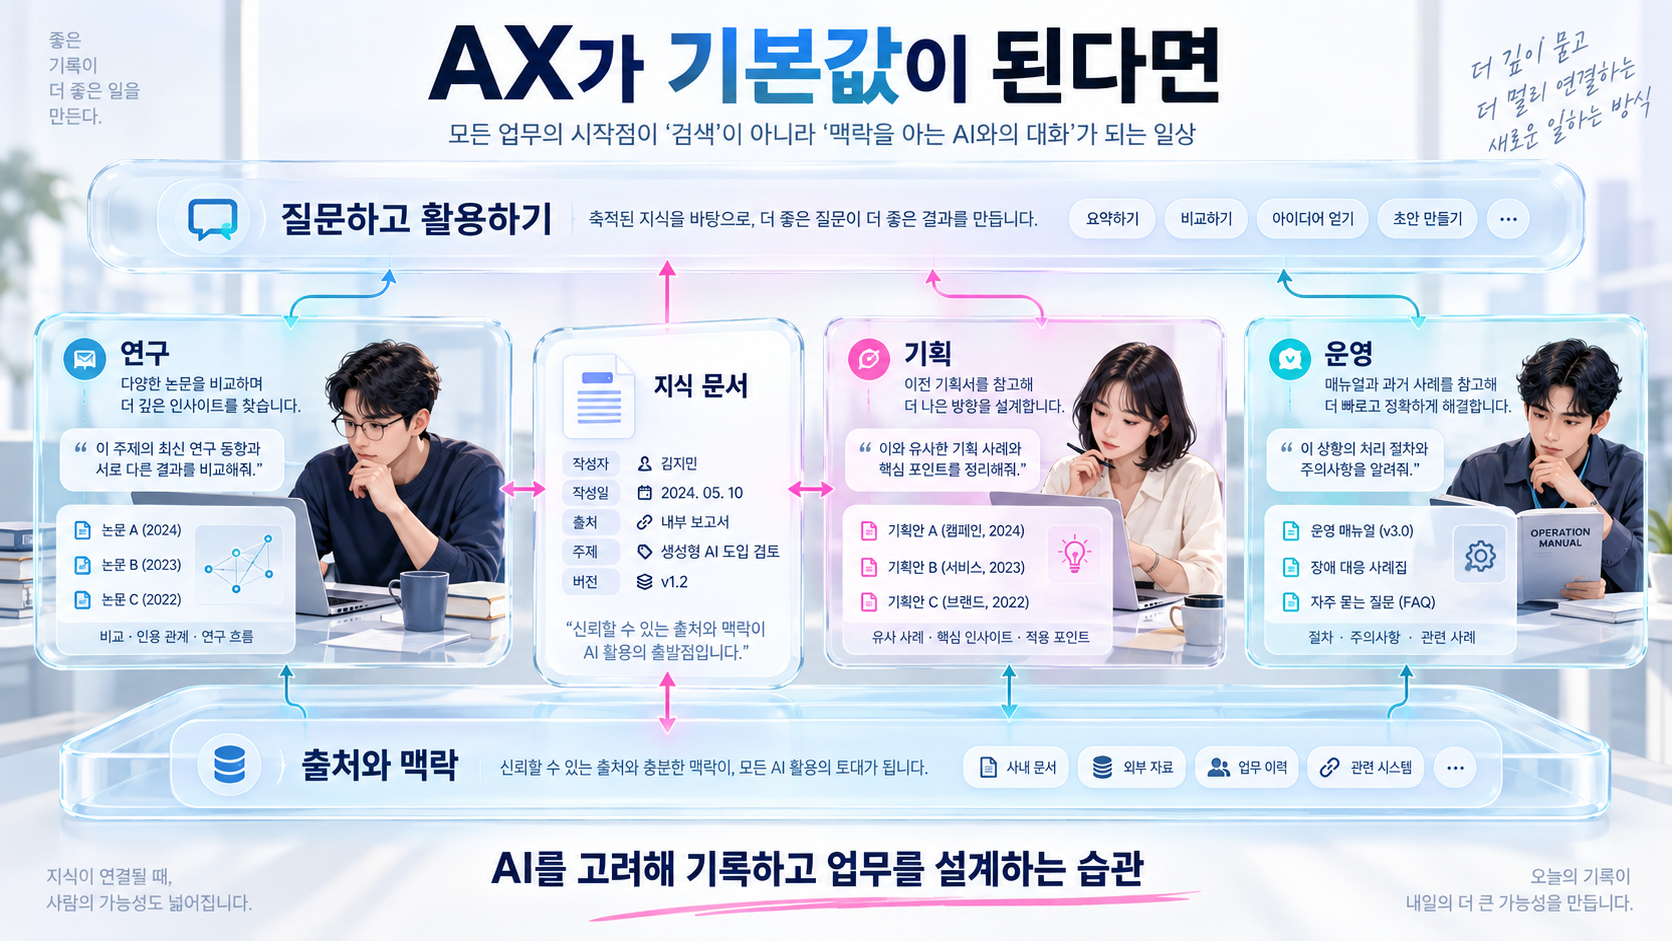
AX(AI Transformation)는 여기에 새로운 기대를 더합니다. 파일을 찾은 뒤 사람이 처음부터 다 읽는 흐름에, AI가 관련 기록을 모으고 비교하고 후속 작업을 돕는 흐름이 들어옵니다.
| 문서에서 하는 일 | 디지털화·DX의 기반 | AX로 확장되는 활용 |
|---|---|---|
| 자료 남기기 | 스캔·파일화·검색 가능한 텍스트 | 출처와 맥락을 보존한 지식 구조 |
| 자료 찾기 | 제목·키워드 검색 | 질문과 관련된 내용을 찾아 근거와 함께 비교 |
| 다음 일 하기 | 사람이 읽고 새 문서 작성 | AI가 초안·연결을 제안하고 사람이 검토 |
예를 들어 연구자는 과거 논문들의 상반된 결론을 출처별로 비교하게 할 수 있습니다. 디자이너는 지난 프로젝트의 요구사항과 수정 기록을 다음 제안서의 참고자료로 쓸 수 있습니다. 작은 회사는 오래된 매뉴얼과 반복 문의를 연결해, 답을 찾는 시간을 줄일 수 있습니다. 가능한 활용의 예이며, 넥서스에서 모두 구현됐다는 뜻은 아닙니다.
OCR은 이 변화의 입구입니다. 이후에는 출처 보존, 검색, 관계 정리, 결과 검토가 필요합니다. 문서를 마크다운으로 바꿨다는 사실만으로 정확한 지식 시스템이 완성되지는 않습니다.
AX가 기본값이 되는 세상
앤드루 응은 AI의 변화를 전기에 비유했습니다.
“AI is the new electricity.”
“AI는 새로운 전기입니다.” — Andrew Ng, 필자 번역
Coursera가 소개한 그의 강연은 전기가 산업 전반을 바꾸었던 것처럼 AI가 여러 산업을 변화시킬 가능성을 다룹니다.
이 비유에서 제가 주목하는 것은 일상성입니다. 우리는 파일을 만들 때 전기를 쓸지부터 고민하지 않습니다. 앞으로는 자료를 남길 때부터 AI가 그 자료를 어떻게 찾고 쓸지 생각하는 일이 자연스러워질 겁니다.
‘AX가 기본값이 된다’는 것은 저의 전망입니다. 모든 일을 AI에 맡긴다는 선언이 아닙니다. 문서를 만들 때 출처와 맥락을 남기고, 반복 업무를 설계할 때 AI가 도울 단계를 검토하는 습관이 기본이 된다는 뜻입니다.
그러면 개인의 경쟁력에도 변화가 생깁니다. 도구를 얼마나 많이 아느냐와 함께, 어떤 불편을 발견하고 어떤 질문을 구체화하느냐가 중요해집니다. 연구자가 느끼는 반복, 작가가 찾지 못하는 기록, 운영자가 매번 손으로 확인하는 일에는 그 사람이 가장 잘 아는 문제가 들어 있습니다.
AI는 그 문제를 설명하는 말과 실행 가능한 소프트웨어 사이의 거리를 줄여 줍니다. 질문만으로 가치가 자동 생성되지는 않습니다. 시도하고, 결과를 확인하고, 다시 질문하는 사람이 아이디어를 쓸 수 있는 것으로 바꿉니다.
무한한 신뢰와 불신을 함께 가지고 질문하기
이 프로젝트를 지나며 제가 갖게 된 태도를 이렇게 적고 싶습니다.
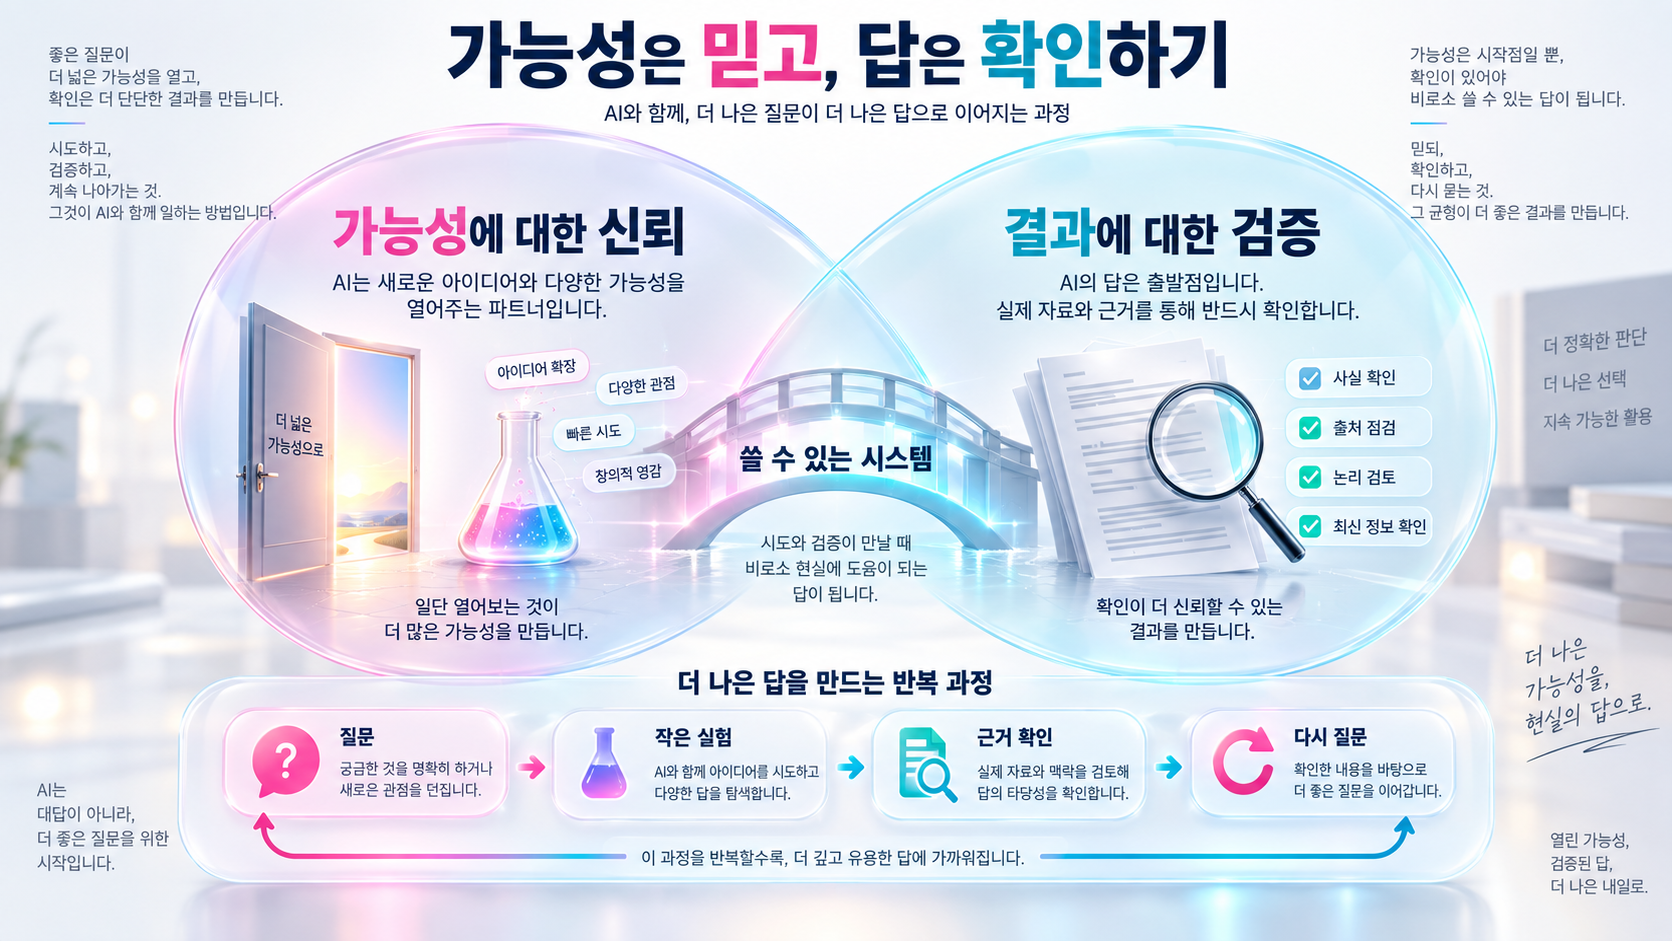
“AI의 가능성에는 무한한 신뢰를, AI의 답에는 끝없는 의심을 품고 질문해야 합니다.”
“Trust AI’s possibilities without limits; question its answers without end.”
— 필자, 이 프로젝트를 통해 정리한 생각
가능성을 믿는다는 것은 지금 모른다는 이유로 시도를 포기하지 않는 태도입니다. 답을 의심한다는 것은 AI가 ‘완료했다’고 말했을 때 실제 파일이 생겼는지, 그 파일의 내용이 맞는지 확인하는 태도입니다.
둘은 함께 있어야 합니다. 가능성에 대한 신뢰가 첫 실험을 시작하게 하고, 결과에 대한 의심이 그 실험을 믿을 만한 시스템으로 만듭니다.
넥서스에서도 그랬습니다. 화면에 ‘업로드 성공’이라고 나왔다고 안심할 수 없었습니다. 반대로 오프라인 표시가 떴다고 컴퓨터가 멈췄다고 단정할 수도 없었습니다. 표시와 실제 상태 사이를 질문으로 좁혀 갔습니다.
AI와 함께 일하는 사람에게 필요한 것은 대답을 빨리 받아들이는 능력만이 아닙니다. 무엇을 근거로 그렇게 판단했는지, 어떻게 다시 확인할 수 있는지 묻는 능력입니다.
다음 프로젝트는 누군가의 작은 불편에서 시작된다
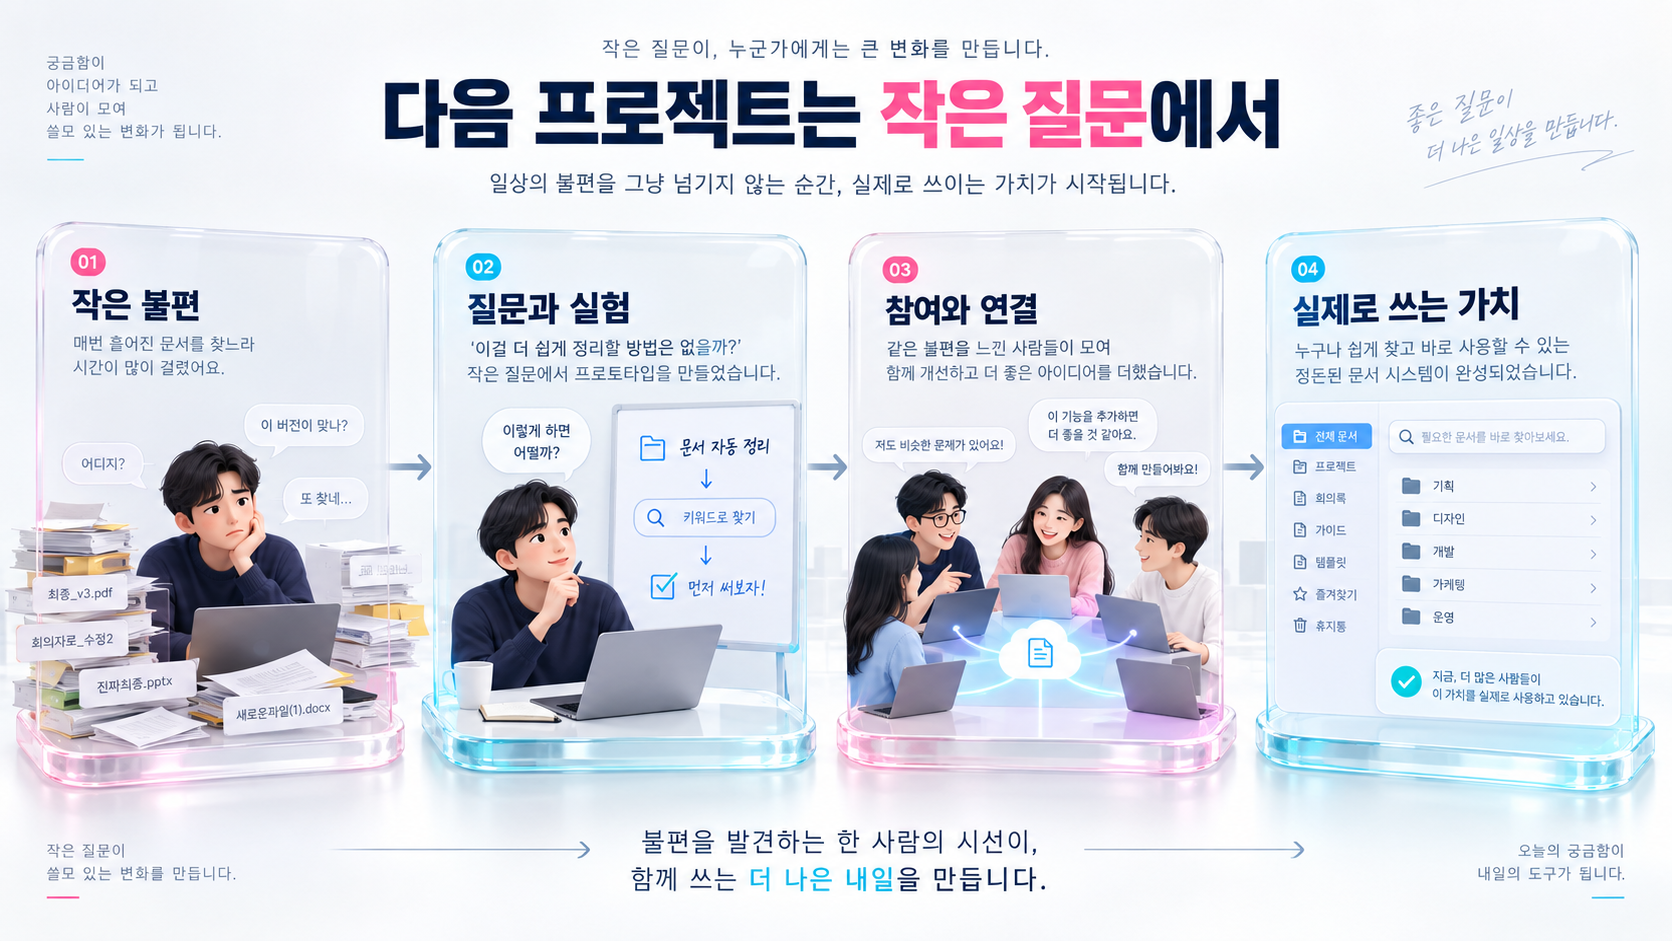
처음에는 읽히지 않는 문서가 있었습니다. 다음에는 너무 오래 걸리는 컴퓨터 한 대가 있었습니다. 그다음에는 작업을 나누자는 질문이 있었고, 자신의 장비와 시간을 보태 준 사람들이 있었습니다.
그 질문은 이제 수백만 페이지의 처리 기록과 다시 쓸 수 있는 자료로 남았습니다.
AI 시대의 변화는 이런 곳에서도 일어납니다. 오랫동안 마음에만 두었던 아이디어를 작게 구현해 보고, 실제로 쓸 수 있는지 확인하고, 다른 사람의 참여를 더해 규모를 키울 수 있습니다. 개인이 발견한 문제와 질문이 구체적인 가치로 전환되는 길이 넓어지고 있습니다.
지금 폴더에 남아 있는 오래된 문서, 매번 반복하는 정리, 시간 때문에 미뤄 둔 프로젝트를 다시 보셨으면 합니다.
그 일이 정말 불가능한지, 아니면 아직 나누어 보지 않았고 연결해 보지 않았던 것인지.
저의 프로젝트는 그 질문에서 돌아가기 시작했습니다.